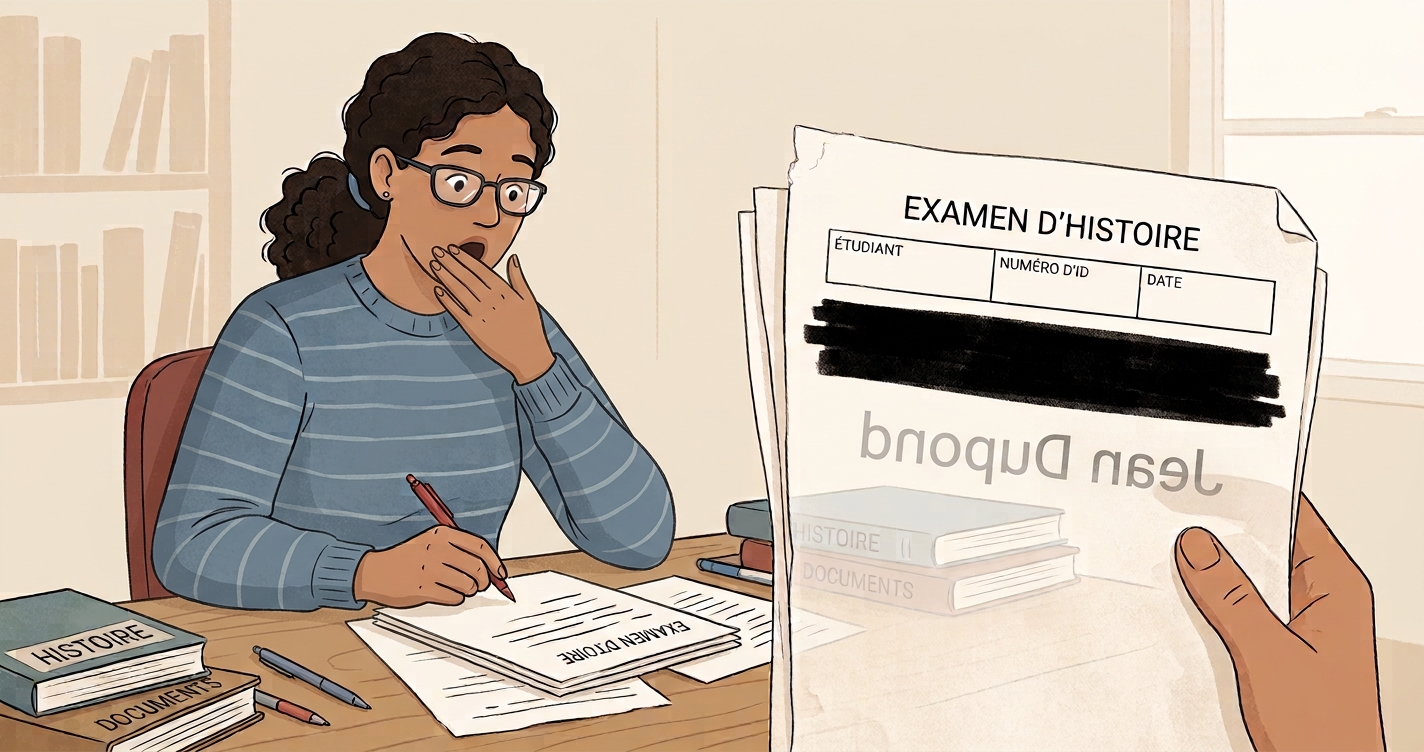
Un concurso, miles de copias, un principio inamovible: el corrector no debe saber quién lo ha escrito.
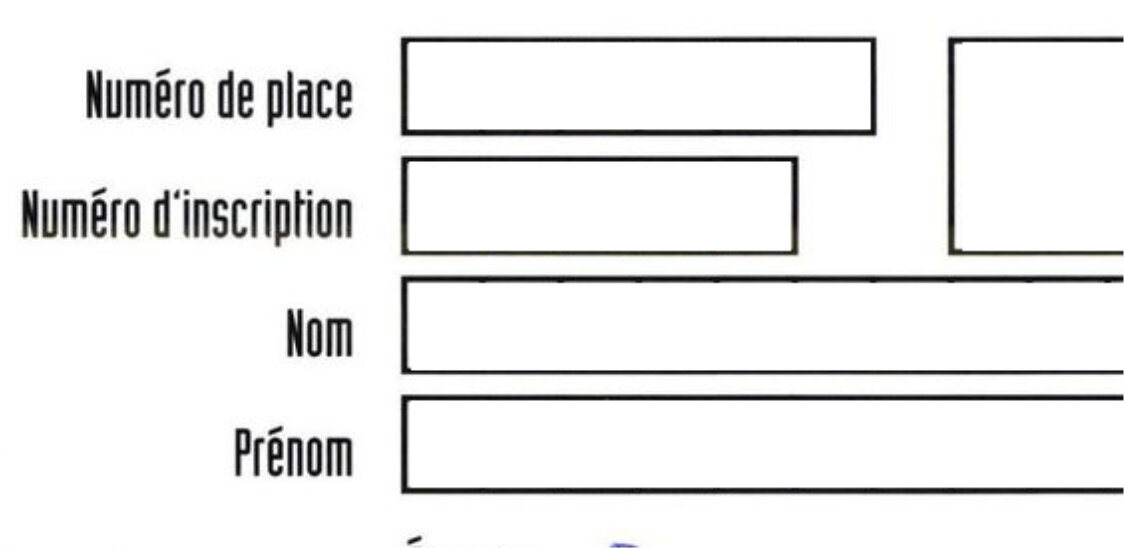
El funcionamiento es sencillo. Se digitaliza la copia. Se localiza el recuadro de identificación en la parte superior de la página. Se coloca una máscara sobre él. El nombre desaparece.
Se coloca la mascarilla. En el lugar adecuado. Por el lado correcto.
Y ahí radica precisamente el problema: por el lado correcto.
| Anverso: identificación ocultada | Reverso: visible en espejo |
|---|---|
 |
 |
Una hoja de papel tiene dos caras
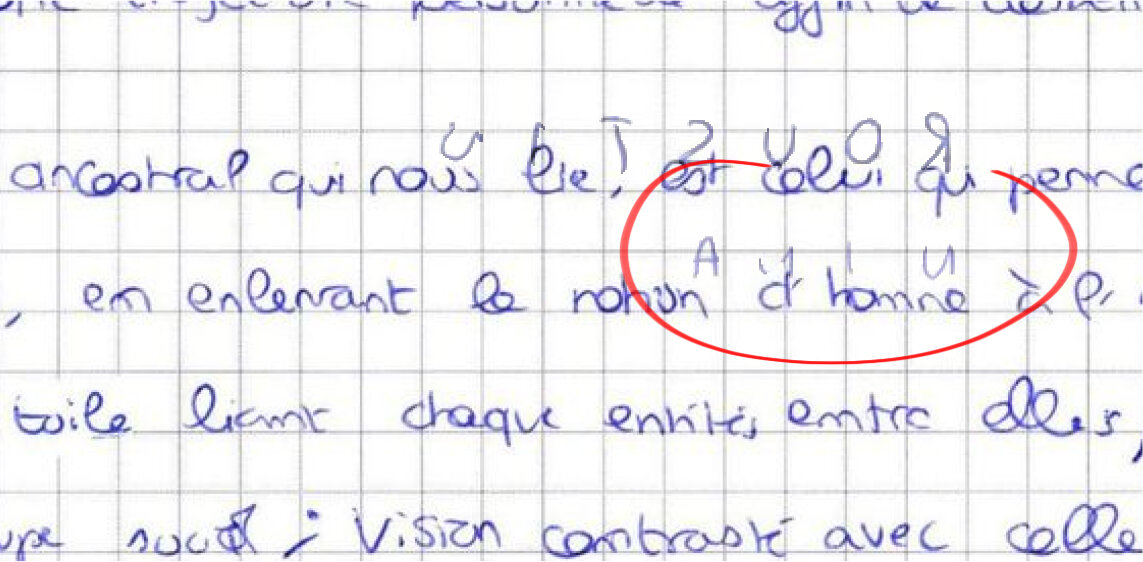
Un candidato escribe con rotulador. O el papel del cuadernillo es un poco demasiado fino. La tinta traspasa el papel.
Da la vuelta a la hoja: encontrarás la imagen invertida de lo que está escrito en el otro lado. A veces aparecen algunos puntos de interferencia. Otras veces, un reflejo perfectamente legible.
Y si lo que se ha pasado es la etiqueta de identificación, entonces el nombre del candidato aparece en el reverso de la página anterior. La máscara no ha visto pasar nada: estaba trabajando en el anverso.
Es un fallo silencioso. Ni una alarma, ni un error, ni un registro. La copia oculta parece impecable, y una página más adelante, el nombre vuelve a aparecer.
Primera idea: se limpia
Es el instinto de cualquier ingeniero. Detectar lo que se ha colado. Borrarlo. Dejar la imagen limpia.
Eso es precisamente lo que no se nos permite hacer.
Un examen corregido es un documento susceptible de ser impugnado. Un candidato puede solicitar que se le permita revisar su examen, y lo que debe revisar es su Copia. No es una versión mejorada mediante un algoritmo.
La mancha de café debe quedar. La marca de la goma de borrar debe quedar. La tachadura ilegible debe seguir siendo ilegible. Si el programa ha borrado discretamente lo que molestaba, el valor probatorio del documento se derrumba, y con él la defensa del organizador.
Por lo tanto, el objetivo no es «hacer que la imagen sea legible». El objetivo es:
Eliminar la transparencia. Y nada más, ni un ápice más.
Eso lo cambia todo. El criterio habitual de éxito en el procesamiento de imágenes: ¿Se lee mejor así? - da paso a un criterio mucho más estricto: ¿Estamos seguros de no haber tocado nada más?
En este caso, un falso positivo no afecta a la calidad. Puede alterar una pieza cuya integridad es importante.
| Reverso tal y como se ha digitalizado |
|---|
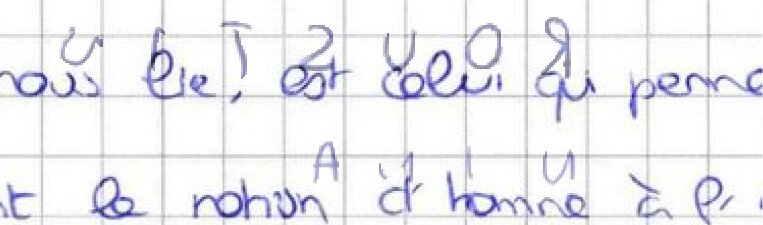 |
| Limpiado mediante umbral de umbral : la cuadrícula y parte de las líneas han desaparecido, pero las letras invertidas más oscuras siguen ahí |
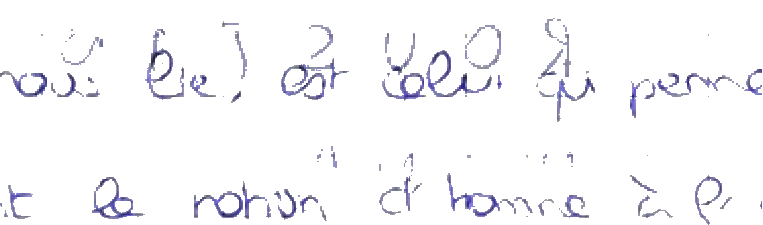 |
| Áreas ocultas : la imagen no se modifica, se colocan máscaras sobre las letras invertidas |
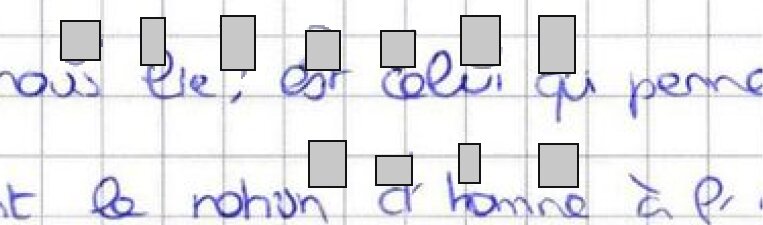 |
La limpieza modifica la copia sin llegar a eliminar toda la transparencia. Ilustración reconstruida.
Segunda idea: la investigación ya ha resuelto eso
Buenas noticias: el fenómeno es conocido, tiene un nombre y se ha estudiado. Los investigadores lo llaman el transparencia, y llevan varias décadas trabajando en ello, sobre todo en los manuscritos antiguos, en los que la tinta traspasa el papel y dificulta la lectura.
En este ámbito se enfrentan dos corrientes de pensamiento.
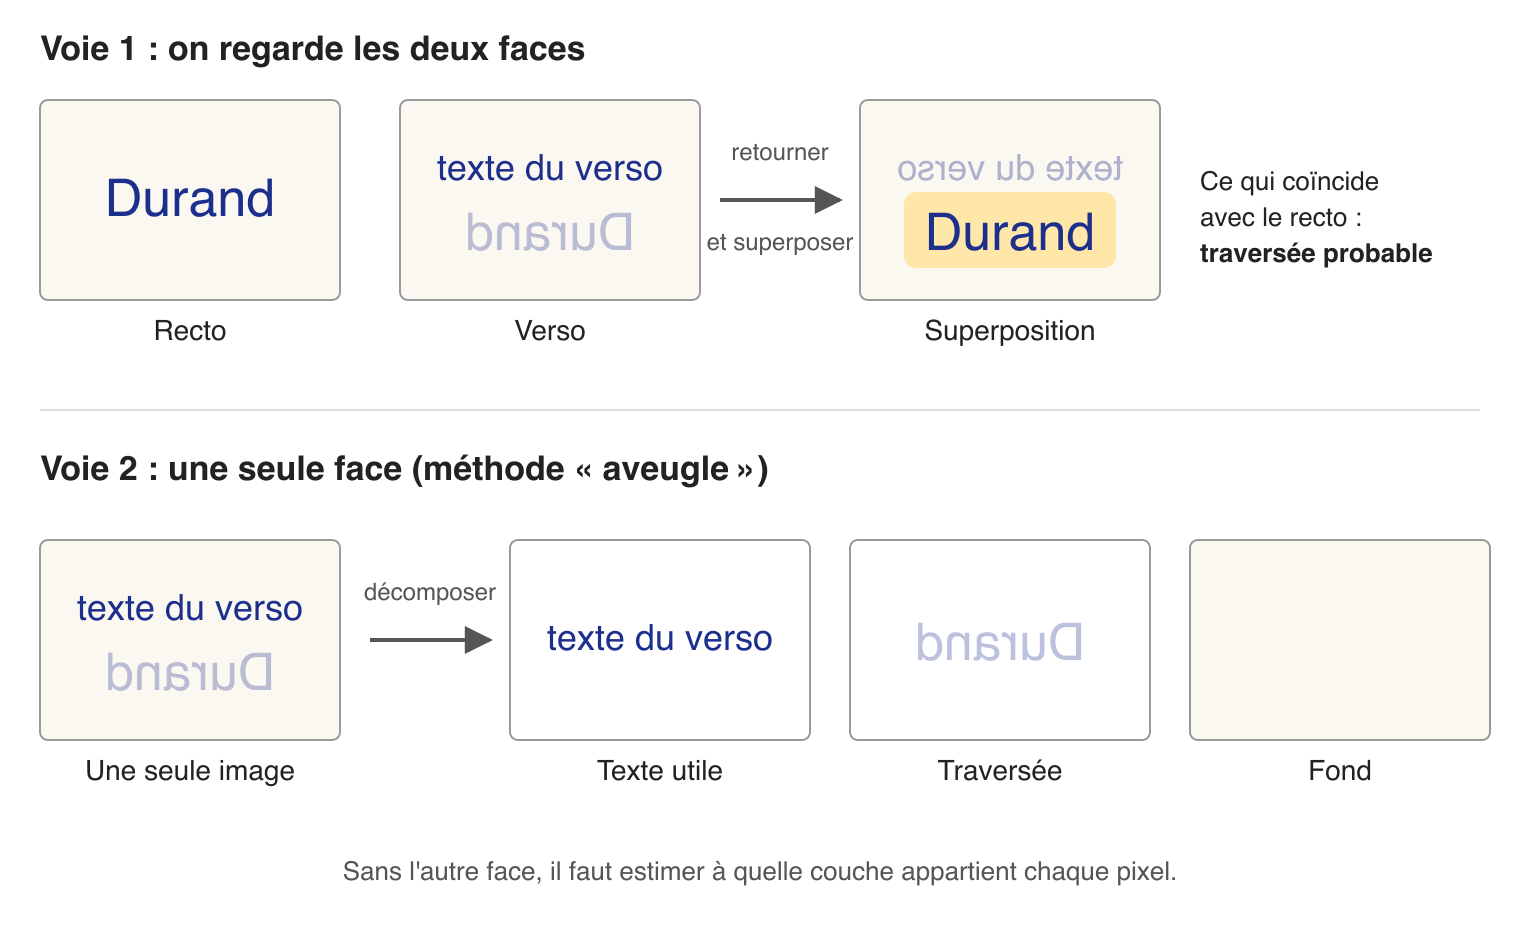
La que mira las dos caras. Se escanean el anverso y el reverso, se superponen, y lo que aparece en ambos lados en el mismo lugar puede ayudar a localizar el cruce. Tres investigadores en procesamiento de imágenes del Trinity College de Dublín, Róisín Rowley-Brooke, François Pitié y Anil Kokaram, publicaron en 2012 una base de datos de veinticinco pares de páginas anotadas a mano y, posteriormente, en 2013, presentaron un marco no paramétrico que aprovecha ambas caras.
La que solo mira a uno. Dicha ciego, solo dispone de una cara y debe estimar qué pertenece a cada capa. Descompone la imagen en texto útil, texto superpuesto y fondo, basándose, sobre todo, en la proximidad de los píxeles. Christian Wolf propuso un método de campos aleatorios en 2009; Bin Sun y sus coautores retomaron este enfoque en 2016 con campos aleatorios condicionales.
Otros trabajos abordan el problema mediante la restauración o la binarización: algunos localizan las zonas deterioradas y luego las reconstruyen, mientras que otros tratan de separar las capas sin reconstruir necesariamente una imagen en color fiel.
Décadas de trabajo, resultados publicados, métodos evaluados en corpus. ¿Y bien?
Pues eso no funciona así tal y como está en nuestro caso
Tres diferencias, todas ellas presentes en la distancia que separa un manuscrito histórico de una copia de examen.
El derecho a embellecer. En un manuscrito antiguo, el objetivo suele ser mejorar la legibilidad; en ese caso, puede ser aceptable suavizar un poco el fondo. En una copia anotada, cualquier modificación del contenido auténtico plantea un problema.
La medida. En este ámbito se saben evaluar métodos de binarización y restauración. Desde 2009, las campañas DIBCO (Concurso de binarización de imágenes de documentos), unas competiciones abiertas que se organizan en el marco de las grandes conferencias internacionales sobre análisis de documentos, en las que los equipos de investigación compiten entre sí y comparan sus resultados en corpus anotados, utilizando métricas como la medida F o la distorsión ponderada por la distancia. Estas métricas también penalizan la supresión de rasgos presentes en la realidad sobre el terreno.
Sin embargo, una puntuación agregada sobre un corpus no garantiza la ausencia de errores en cada documento. Y una medida F de 0,98 no significa, por sí sola, que se haya eliminado el 2 % del texto válido: esta puntuación combina errores de varios tipos y depende de la definición de las clases y del conjunto de datos evaluado.
Estas medidas se calculan en función de una realidad sobre el terreno: una anotación de lo que realmente es tinta. Existe para los juegos de prueba anotados, no para cada copia que entra en producción. Sin esta referencia independiente, no se puede deducir, solo a partir de la puntuación, si un trazo concreto se ha eliminado por error o se ha conservado correctamente.
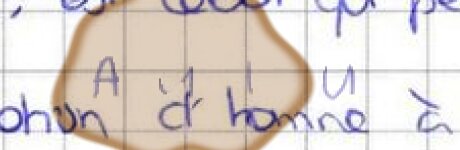
El fondo. Los métodos de reconstrucción deben estimar qué había debajo de la tachadura. En una copia real, el texto oculto puede solaparse con una mancha de tinta, un subrayado o un rastro de goma de borrar. Por lo tanto, el fondo que hay que conservar no siempre es uniforme, y reconstruirlo fielmente supone una dificultad añadida.
| Una mancha bajo la transparencia | Tras la limpieza mediante detección de umbral |
|---|---|
 |
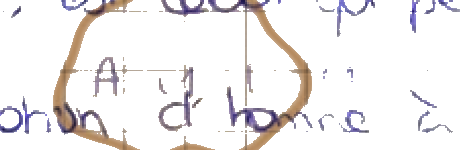 |
En este caso, reconstruir el fondo significa reconstruir la mancha. El umbral borra el interior de la mancha, conserva su contorno y deja las letras invertidas. Ilustración reconstruida.
Y el terreno aún tiene mucho por clasificar
A la exigencia de conservar el original se suman cuatro limitaciones operativas.
Automático. No se realizan modificaciones manuales en las copias individuales. En nuestro contexto, una persona que abra una copia para eliminar una identidad corre el riesgo de conocer su contenido, lo que compromete el objetivo del anonimato.
Reversible. El original debe poder recuperarse tal y como está.
Trazada. Hay que poder decir más adelante qué se ha ocultado, dónde, cuándo y mediante qué versión del tratamiento.
Rápido. La copia pasa del escáner a la pantalla del corrector. El procesamiento debe realizarse dentro de ese plazo.
Entonces, ¿qué hacemos?
Dejamos de intentar restaurar la imagen original.
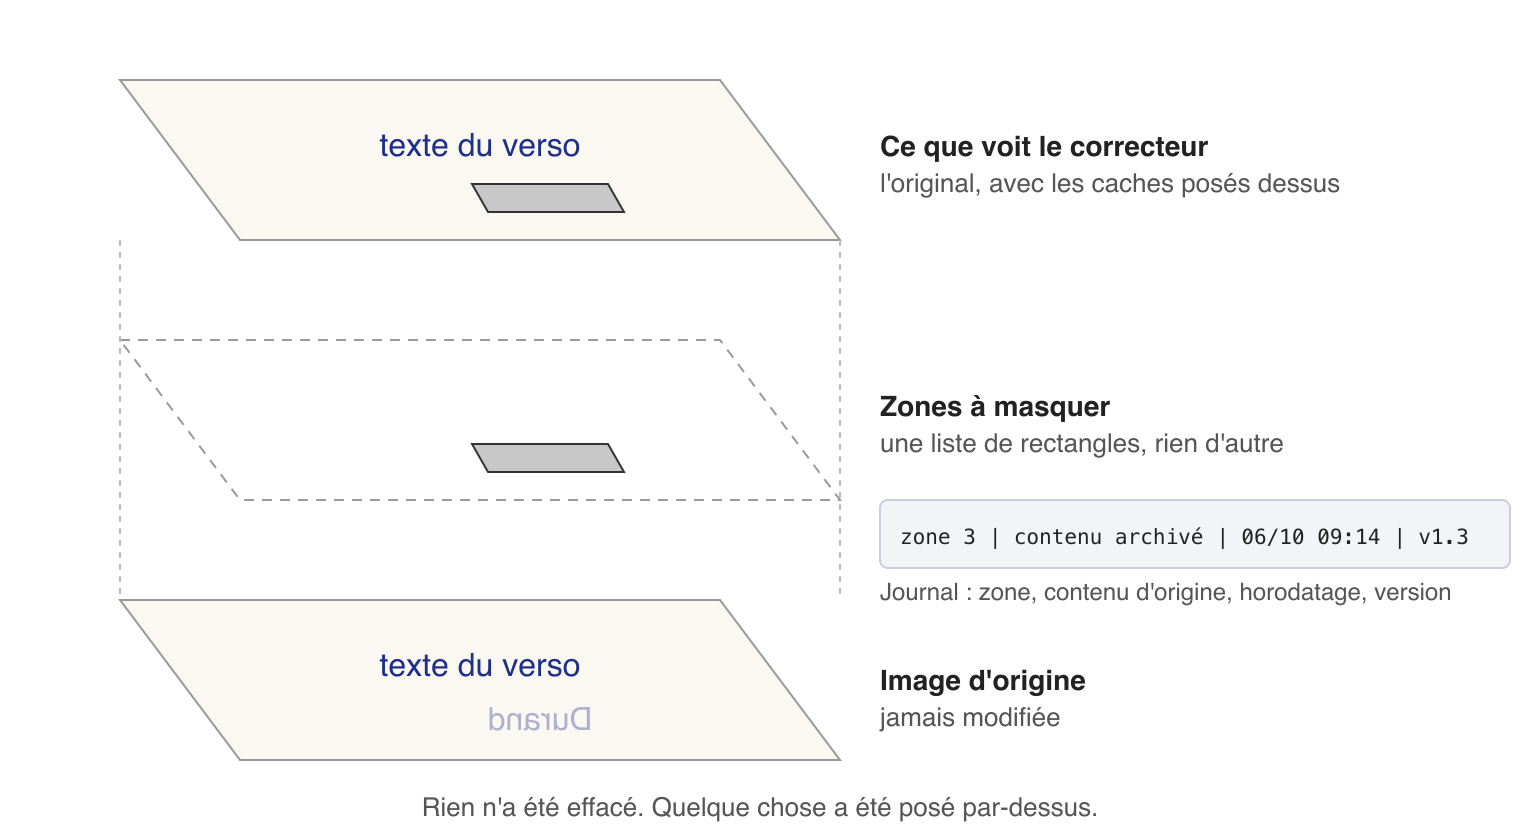
Estas limitaciones sugieren otra solución: no una copia depurada, sino una lista de zonas que hay que ocultar, aplicada sin modificar el archivo original.
La imagen original permanece intacta. Lo que ve el corrector es una capa superpuesta, reversible, con historial y que no ha borrado nada del archivo.
En caso de impugnación, se puede conservar un registro de las zonas ocultadas, su contenido original, la fecha y hora y la versión del tratamiento.
Las investigaciones sobre los documentos no se limitan a la restauración mediante software: dependiendo del caso, también se recurre a técnicas especializadas, como la imagenología infrarroja o multiespectral, los rayos X y la tomografía 3D. Estas herramientas no forman parte de nuestro ámbito de trabajo: aquí disponemos de un escáner convencional y de un programa informático. Esta limitación define nuestro objetivo de investigación, distinto de la restauración: localizar y decidir si un trazo procede de la otra cara en lugar de de la cara examinada.
Queda la parte difícil: hacerlo de forma automática, sin supervisión y con un nivel de confianza suficiente, sin ocultar ningún rasgo propio del rostro examinado.
A tener en cuenta
Un mecanismo de anonimización puede estar bien diseñado, bien programado y aplicado en el lugar adecuado, y aun así fallar, porque se basa en una de las dos caras de un objeto. Ninguna revisión de código puede subsanar eso. Hay que consultar el artículo.
Y una vez detectada la falla, la solución técnica más obvia —limpiar la imagen— puede resultar inadecuada si es necesario preservar la integridad de la copia.
Se trata de un aspecto clave siempre que un programa informático procesa un documento que tiene valor legal. El requisito de integridad no es algo que venga después de la solución: contribuye a determinar qué soluciones son aceptables.